
 LinkT&B 編集部
生成AIの導入では、資料を取り込めたことと、業務で正しく使えることを分けて確認します。回答の根拠、閲覧権限、最新版の参照、確認にかかる時間を評価すると、試行の段階で運用上の問題を見つけられます。
この記事の内容
「うちもそろそろ生成AIを導入しよう」――2025年から2026年にかけて、この言葉を経営層から聞かない企業のほうが少なくなりました。ChatGPTの登場以降、大企業だけでなく中小企業でも生成AI導入の検討が急速に進んでいます。しかし、総務省の「情報通信白書 令和6年版」によると、日本企業で生成AIの活用方針を策定済みの企業は42.7%、特定業務で使用中の企業は46.8%に達する一方、実際に効果を創出できている企業はまだ限定的です。BCGの2024年調査では企業の約74%がAI全般の価値創出やスケールに苦戦していると報告されており、PoCから本番運用に至る道のりは想像以上に険しいのが実情です。
本記事では、生成AIを社内に導入する際に多くの企業がはまる「5つの落とし穴」を整理し、それぞれの回避策を実践レベルで解説します。特に、IT専任部門が少ない中小企業が限られた予算と人員で成果を出すための視点を重視しています。
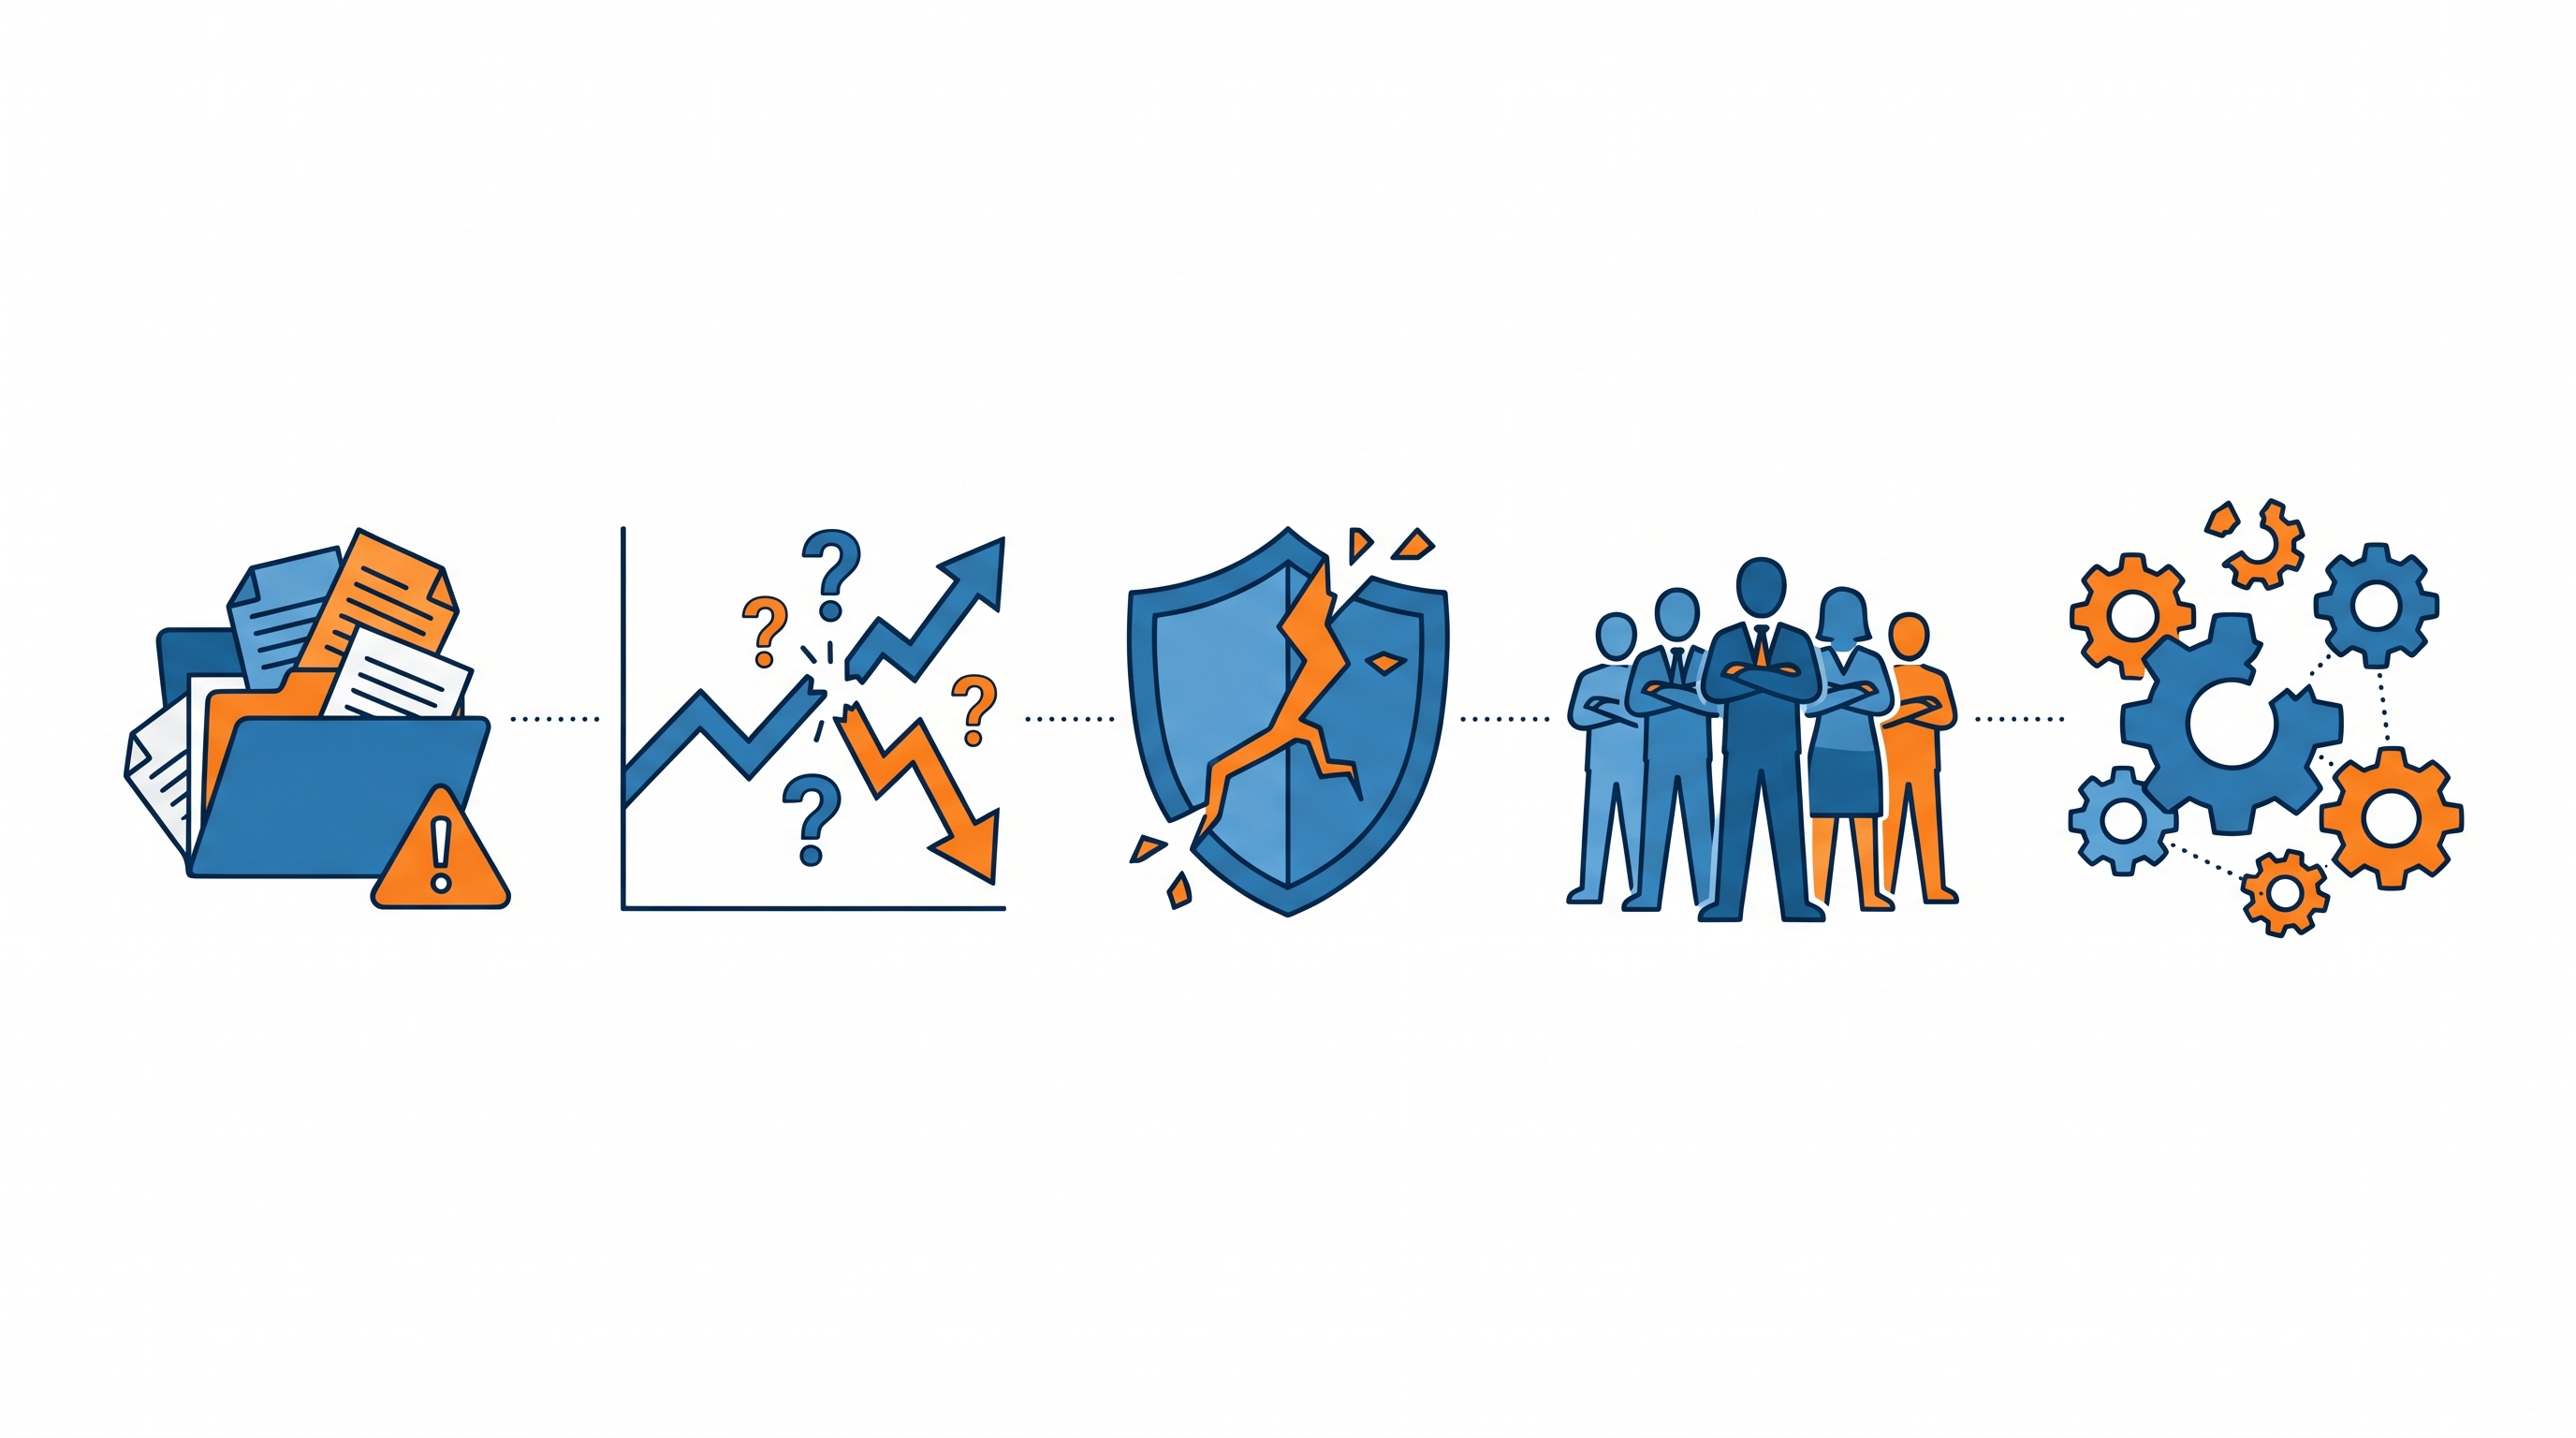
図1. 生成AI導入における5つの落とし穴の相関。どれか1つでも見落とすとPoC止まりに陥りやすい。
試行で確かめる失敗しやすい場面
| 項目 | 確認すること | 判断に使うもの |
|---|---|---|
| 根拠不足 | 資料に答えがない質問 | 分からないと返せるか |
| 権限 | 閲覧できない資料への質問 | 検索結果や要約から漏れないか |
| 更新 | 新旧の手順書が混在 | 正しい版と施行日を示せるか |
落とし穴1:データ準備の過小評価
生成AIの出力品質は、モデルの能力だけでなく、入力データの質に大きく左右されます。にもかかわらず、多くのPoCプロジェクトではモデル選定に時間をかける一方で、社内データの整理・クレンジングを軽視しがちです。
典型的な失敗パターンは次のとおりです。社内のマニュアルや議事録をそのままRAG(Retrieval-Augmented Generation)に投入したところ、古い規定や廃止された手順書が混在し、AIの回答精度が大幅に低下するケースです。あるいは、PDF化された紙の帳票をOCRで読み取った際に誤変換が大量に発生し、結局は人手で修正するコストがPoC予算を超えてしまうパターンもあります。
回避策
まずは対象業務を1つに絞り、その業務で使うドキュメントだけを対象にデータ整備を行いましょう。全社のナレッジを一気にAI化しようとすると、データ範囲やドキュメントの整備状況によってはデータ準備だけで数ヶ月単位の期間を要することも珍しくありません。社内FAQ対応や定型レポートの下書きなど、データ範囲が限定される業務から始めるのが鉄則です。
落とし穴2:ROI設計の欠如
「AIを入れれば生産性が上がる」という漠然とした期待だけで予算を確保すると、PoC終了後に「で、いくら儲かったの?」という問いに答えられず、本番移行の稟議が通りません。
生成AIのROIを測定するには、導入前のベースラインを定量的に記録しておく必要があります。たとえば、問い合わせ対応に1件あたり平均15分かかっていたものが、AI支援で8分に短縮できたなら、月間の対応件数×7分の時間削減として金額換算できます。しかし、このベースライン測定をPoCの前にやっておかなければ、効果を証明する術がありません。
回避策
PoC開始前に「何を・どの単位で・どのくらい改善したら成功とみなすか」を定義してください。KPIは処理時間、エラー率、対応件数など、既存業務で計測可能な指標に限定します。「AIで創造性が上がった」のような定性指標は、経営層の意思決定材料にはなりにくいのが現実です。
落とし穴3:セキュリティとガバナンスの後回し
クラウドベースの生成AIサービスを利用する場合、サービスの種類によってデータの取り扱いが異なる点に注意が必要です。個人向けサービス(ChatGPTの無料プランなど)では入力データが学習に使われる可能性がありますが、Enterprise/API向けプラン(Azure OpenAI、Google Cloud の Gemini API など)では学習不使用が明記されています。また、データの保存リージョンや法的管轄も、契約やリージョン設定で制御できる場合があります。しかし、こうした使い分けを理解しないままPoCを始め、機密情報を含むデータを外部サービスに送信してしまい、セキュリティ部門から停止を命じられる事態は十分に起こり得ます。
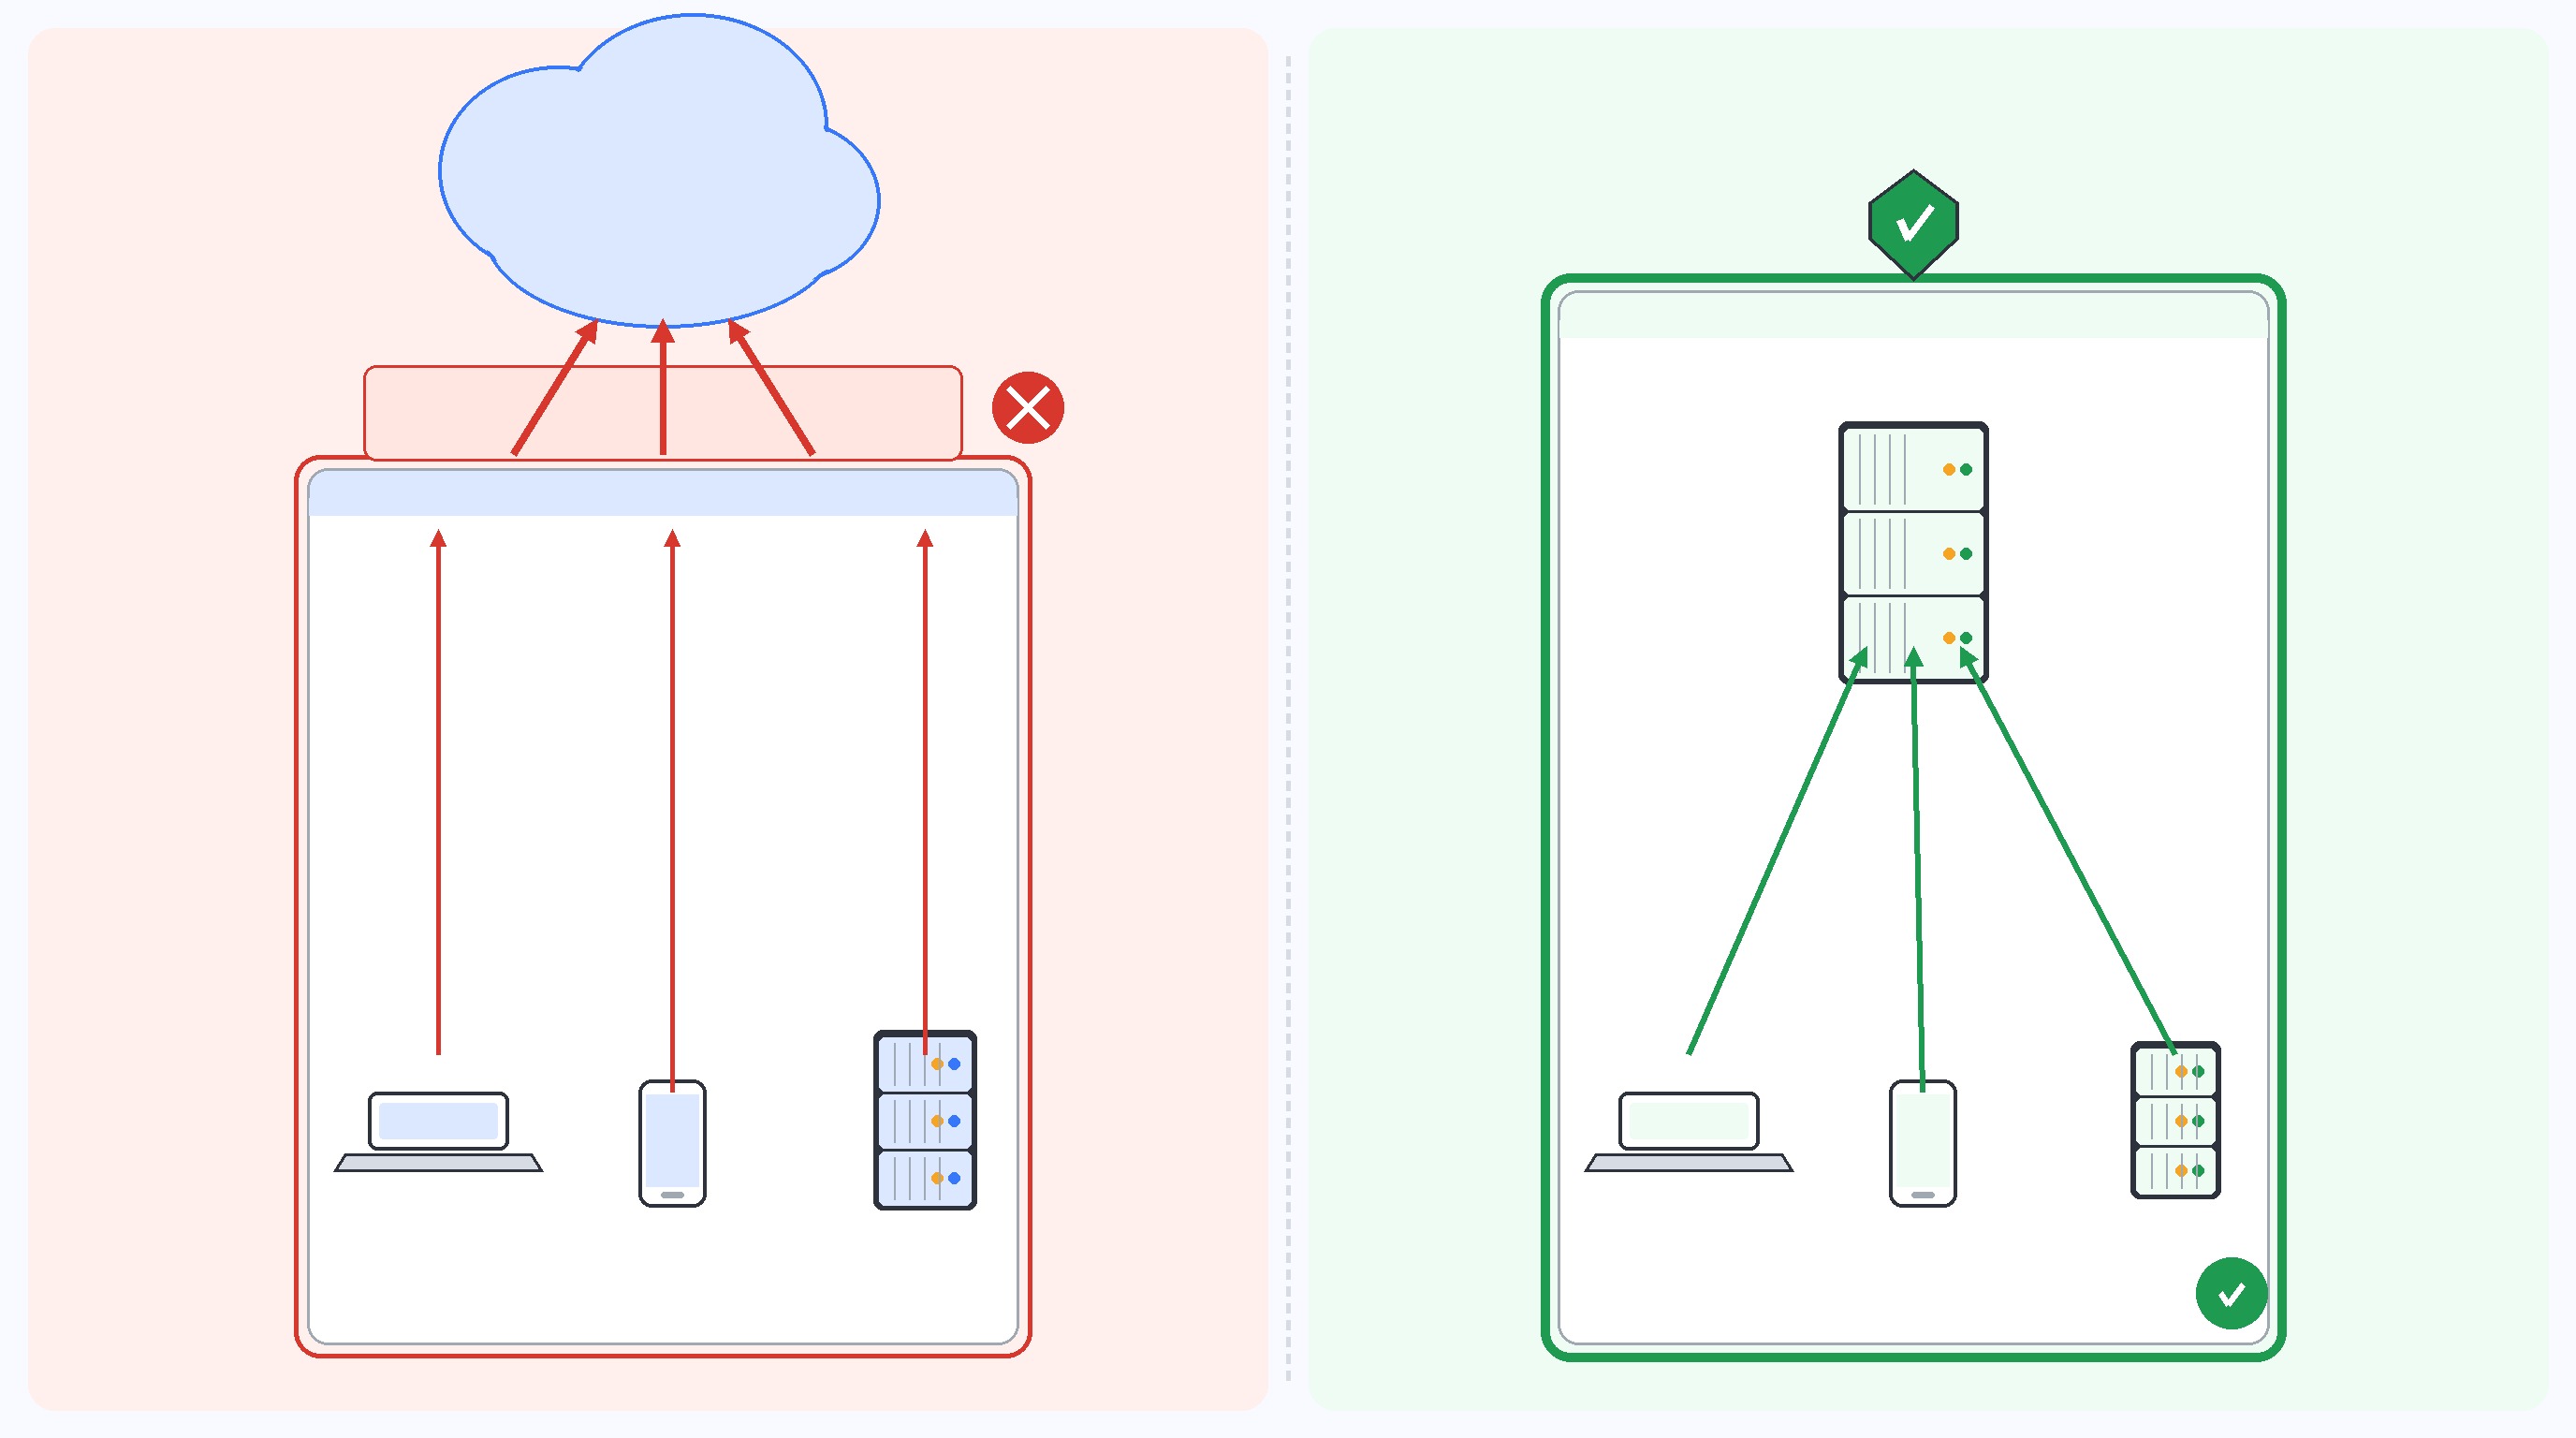
図2. クラウドAI(左)とオンプレミス/ローカルLLM(右)のデータフロー比較。左図ではPC・スマホ・サーバーのデータが社外のクラウドへ送信されるため漏洩リスクが生じる。右図ではファイアウォール内のローカルサーバーで処理が完結し、データが外部に出ない。
特に製造業や金融業など、取引先との秘密保持契約(NDA)が厳しい業種では、外部サービスへのデータ送信が守秘義務契約や営業秘密管理に抵触し得るため、契約内容と運用設計の事前確認が不可欠です。
回避策
PoC計画の段階で、情報セキュリティ部門(またはそれに準ずる責任者)をプロジェクトメンバーに加えてください。利用するデータの機密レベルを分類し、機密性の高いデータを扱う場合はクラウドAPIではなくローカルLLM(オンプレミスで稼働する言語モデル)の採用を検討すべきです。ただし、ローカルLLMであれば外部送信リスクは低減できる一方、権限管理・ログ管理・モデル更新・脆弱性対応・監査証跡などの運用責任は自社側に移る点を忘れてはいけません。当社のローカルLLM導入支援でも、最初のヒアリングで必ずデータの機密分類と運用責任範囲の整理を行っています。
落とし穴4:現場の抵抗と変革管理
技術的にPoCが成功しても、現場が使わなければ意味がありません。「AIに仕事を奪われる」という漠然とした不安、「いままでのやり方で問題ない」という慣性、そして「使い方がわからない」という教育不足。この3つが組み合わさると、せっかく構築したAIシステムが誰にも使われないまま予算だけが消化されていきます。
IPAの「DX動向2024」でも、DX推進において人材確保と企業文化・風土の変革が重要テーマとして取り上げられています。BCGの「10-20-70原則」でも、AIの価値創出においてアルゴリズムは10%、技術・データは20%、残る70%は人とプロセスの変革に関わるとされており、技術だけでは解決できない問題です。
回避策
導入の初期段階から、実際にAIを使う現場メンバーをプロジェクトに巻き込みましょう。PoCの対象業務は、現場が「これは面倒だ」と感じている作業を選ぶのがコツです。面倒な仕事が楽になるという実感があれば、現場は自発的にAIを使い始めます。トップダウンで「AIを使え」と命じるだけでは、形だけの利用で終わります。
落とし穴5:運用体制の未設計
PoCは3ヶ月で終わりますが、運用は何年も続きます。モデルのバージョンアップ、データの追加・更新、プロンプトの改善、ユーザーからのフィードバック対応、障害時の切り戻し――これらを誰が、どのような体制で、どのくらいの予算で維持するのかを、PoCの時点で設計しておく必要があります。
クラウドAIの場合、API料金の従量課金が想定以上に膨らむリスクもあります。PoCでは少量のテストデータで試しますが、全社展開すると利用量が大幅に増加します。利用するモデルや前提条件(トークン数、ユーザー数、呼び出し頻度)によってコストは大きく変動するため、全社展開時の想定利用量に基づくコスト試算をPoC段階で行っておくことが重要です。
回避策
運用フェーズのコスト試算をPoCと同時に行いましょう。特にAPI利用料は、全社展開時の想定利用量×単価で月額コストを見積もっておくべきです。コストが許容範囲を超える場合は、高頻度利用・長期運用・内製運用力がある前提であれば、ローカルLLMによるオンプレミス運用が選択肢になります。初期のGPU調達や運用人件費は必要ですが、利用量が多いほどランニングコストを抑えやすくなります。
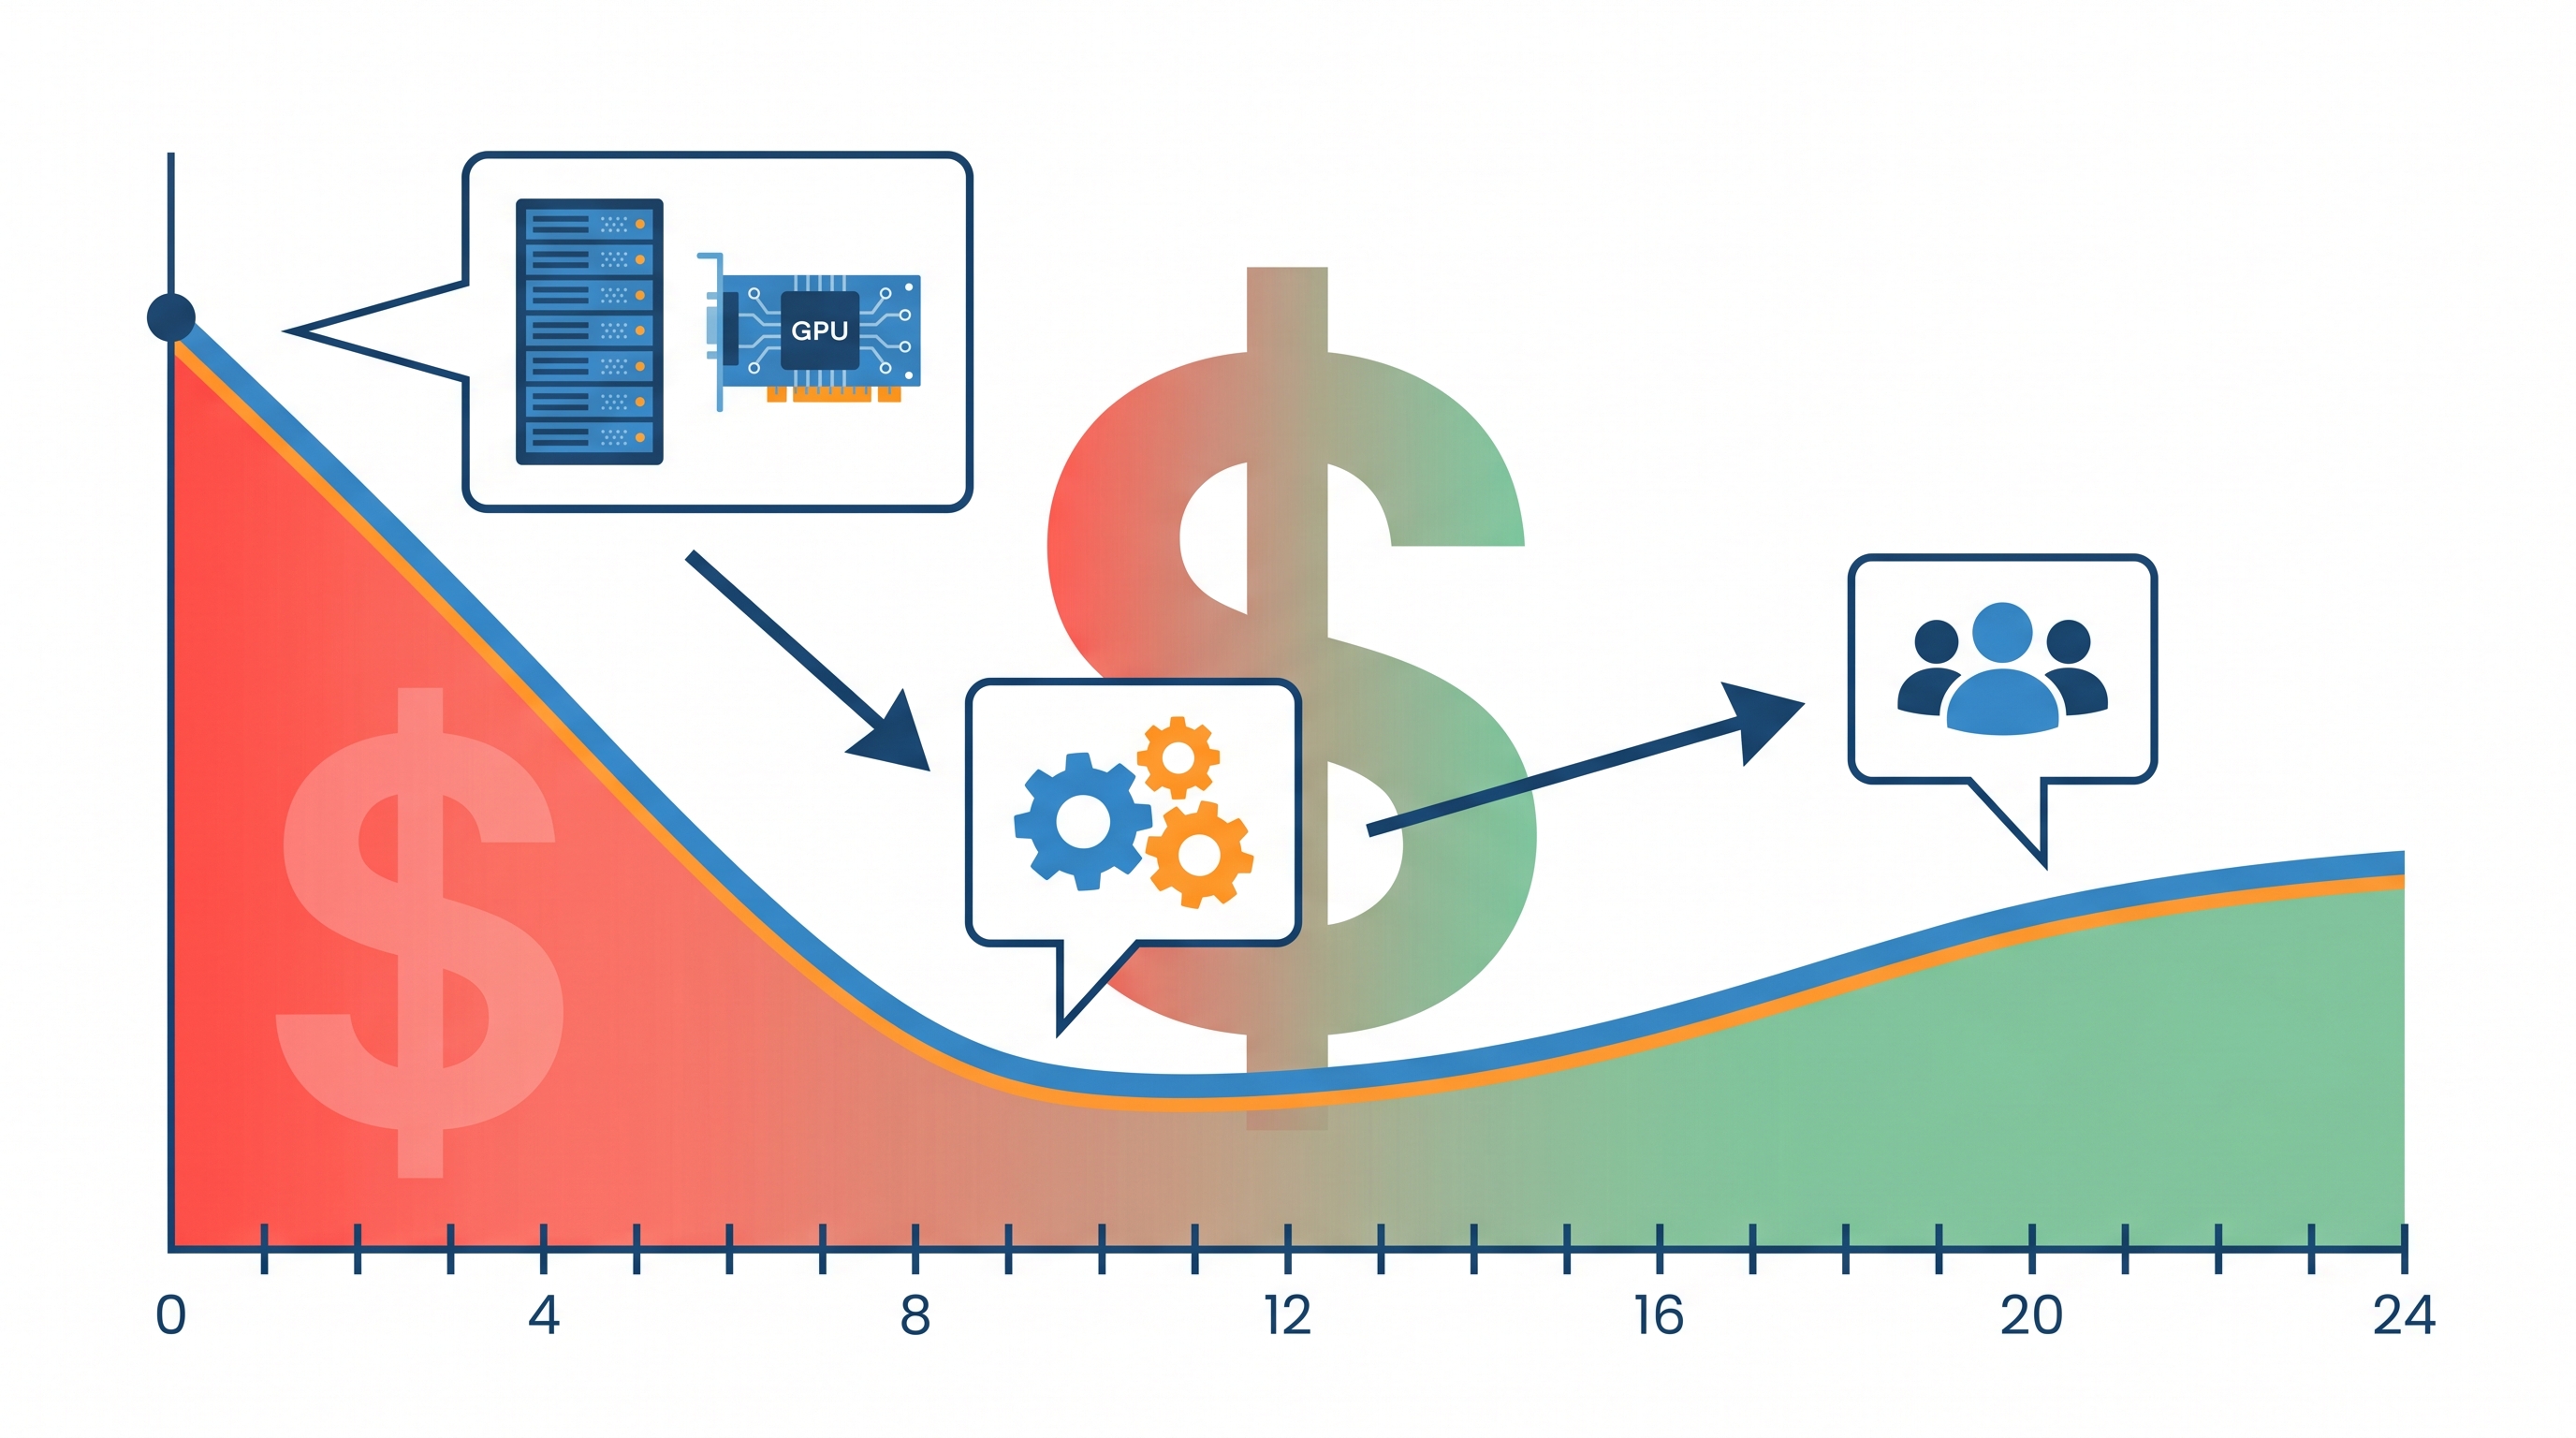
図3. クラウドAPI従量課金 vs ローカルLLM固定費のコスト推移イメージ(横軸:月数)。ローカルLLMは初期にGPU調達コスト(左端)が大きいが、月を追うごとに保守・運用費(中央:歯車)と人件費(右:人物)が中心となり、利用量が多い場合はクラウドAPIの累積課金を下回り得る。実際の損益分岐点はモデル規模・利用量・運用体制により異なるため、TCOでの比較が必要。
5つの落とし穴を俯瞰する:共通する根本原因
これら5つの落とし穴に共通するのは、「技術の導入」を「業務の変革」と混同しているという点です。生成AIはあくまでツールであり、ツールを導入しただけでは業務は変わりません。業務プロセスの再設計、人の意識改革、運用体制の構築――これらがセットで動いてはじめて、PoCが本番運用に進みます。
| 落とし穴 | 根本原因 | 回避のキーアクション |
|---|---|---|
| 1. データ準備の過小評価 | 全社一括導入の幻想 | 対象業務を1つに絞る |
| 2. ROI設計の欠如 | 定量指標なき期待 | PoC前にベースライン測定 |
| 3. セキュリティの後回し | 技術先行・ガバナンス後追い | 初期段階でセキュリティ部門参画 |
| 4. 現場の抵抗 | トップダウン偏重 | 現場の「面倒な仕事」から始める |
| 5. 運用体制の未設計 | PoC≠本番の認識不足 | 運用コスト試算をPoCに組み込む |
中小企業こそ有利な理由
ここまで読むと「大企業じゃないと無理では」と感じるかもしれませんが、実は中小企業のほうが有利な側面があります。意思決定が速い、組織の階層が少ないため現場とのコミュニケーションが取りやすい、そして全社展開の規模が小さいため初期投資を抑えられる。大企業が社内調整に半年かかるところを、中小企業なら1ヶ月で動き出せることも珍しくありません。
重要なのは、最初から完璧を目指さないことです。1つの業務、1つのチーム、1つのユースケースで小さく始めて、成果が出たら横展開する。このアプローチが、限られたリソースで最大の効果を出す王道です。
まとめ:PoCの前にやるべきことリスト
最後に、本記事の内容をPoC開始前のチェックリストとして整理します。
- 対象業務を1つに絞り、その業務のデータ範囲を明確にしたか
- 現状の業務指標(処理時間・エラー率など)をベースラインとして記録したか
- 成功基準を定量KPIで定義したか
- データの機密レベルを分類し、セキュリティ責任者を巻き込んだか
- 現場メンバーがプロジェクトに参画しているか
- 運用フェーズの体制とコスト(API料金 or ローカルLLM固定費)を試算したか
これらを事前に押さえておくだけで、PoC止まりに陥る確率は大幅に下がります。生成AIの導入は、正しい順序で、正しい範囲で始めれば、中小企業でも十分に成果を出せる取り組みです。
ご相談ください
LinkT&Bでは、生成AIの導入検討からPoC設計、ローカルLLMの構築・運用までをワンストップで支援しています。「何から始めればいいかわからない」「PoCを始めたが行き詰まっている」といった段階からでもご相談いただけます。IT・AIソリューション事業のページをご覧いただくか、お問い合わせから直接ご連絡ください。
参考資料
- 総務省「令和6年版 情報通信白書」
- BCG「From Potential to Profit with GenAI(2024)」
- IPA「DX動向2024」
- OpenAI「How your data is used to improve model performance」
- Microsoft「Azure OpenAI Service データプライバシー」
- Google Cloud「Gemini API データガバナンス」
関連記事
ローカルLLM導入を"一社完結"で — ワンストップ支援が解く3つの詰まり / クラウドAIに潜む4つの構造的リスク / ローカルLLMという構造的な答え / クラウドAIのデータは本当に安全か?
参考資料:NIST:生成AIリスク管理
ローカルLLM・業務AI導入支援の相談
社内で扱う情報と対象業務を確認し、AIの構成、検証方法、導入後の運用を提案します。現在お使いの環境からご相談いただけます。